

O‘rtacha qiymat gipotezasini tekshirish (chap tomonlama)
Bosh to‘plam o‘rtachasi — bosh to‘plam qiymatlarining o‘rtachasi.
Gipoteza testlari o‘sha bosh to‘plam o‘rtachasining kattaligi haqidagi da’voni tekshirish uchun ishlatiladi.
O‘rtacha qiymat gipotezasini tekshirish
Gipoteza testi uchun quyidagi bosqichlardan foydalaniladi:
- Shartlarni tekshirish
- Da’volarni aniqlash
- Ahamiyatlilik darajasini tanlash
- Test statistikasini hisoblash
- Xulosa
Masalan:
- Bosh to‘plam: Nobel mukofoti sovrindorlari
- Kategoriya: mukofotni olgan paytdagi yoshi.
Va biz quyidagi da’voni tekshirmoqchimiz:
"The average age of Nobel Prize winners when they received the prize is less than 60"
Tasodifiy tanlangan 30 nafar Nobel mukofoti sovrindoridan iborat tanlanma olib, quyidagini aniqlashimiz mumkin:
The mean age in the sample (\(\bar{x}\)) is 62.1
The standard deviation of age in the sample (\(s\)) is 13.46
Bu tanlanma ma’lumotlari asosida da’voni quyidagi bosqichlar orqali tekshiramiz.
1. Shartlarni tekshirish
Ulush uchun ishonch oralig‘ini hisoblash shartlari:
- Tanlanma tasodifiy tanlangan
- Va quyidagilardan biri:
- Bosh to‘plam ma’lumotlari normal taqsimlangan
- Tanlanma hajmi yetarlicha katta
O‘rtacha kattalikdagi tanlanma hajmi, masalan 30, odatda yetarli hisoblanadi.
Misolda tanlanma hajmi 30 ga teng bo‘lgan va u tasodifiy tanlangan, shuning uchun shartlar bajarilgan.
Eslatma: Ma’lumotlar normal taqsimlanganini maxsus statistik testlar yordamida tekshirish mumkin.
2. Da’volarni aniqlash
Tekshirilayotgan da’vo asosida nol gipoteza (\(H_{0}\)) va muqobil gipotezani (\(H_{1}\)) aniqlashimiz kerak.
Da’vo quyidagicha edi:
"The average age of Nobel Prize winners when they received the prize is less than 60"
Bu holda parametr — Nobel mukofoti sovrindorlarining mukofotni olgan paytdagi o‘rtacha yoshi (\(\mu\)).
U holda nol va muqobil gipotezalar:
Null hypothesis: The average age was 60.
Alternative hypothesis: The average age was less than 60.
Buni belgilar yordamida quyidagicha ifodalash mumkin:
\(H_{0}\): \(\mu = 60 \)
\(H_{1}\): \(\mu < 60 \)
Bu "chap tomonlama" test, chunki muqobil gipoteza ulush nol gipotezadagidan kamroq ekanini da’vo qiladi.
Agar ma’lumotlar muqobil gipotezani qo‘llab-quvvatlasa, nol gipotezani rad etamiz va muqobil gipotezani qabul qilamiz.
3. Ahamiyatlilik darajasini tanlash
Ahamiyatlilik darajasi (\(\alpha\)) — gipoteza testida nol gipotezani rad etayotganda biz qabul qiladigan noaniqlik.
Ahamiyatlilik darajasi — tasodifan noto‘g‘ri xulosa chiqarish ehtimolligining foizdagi ifodasi.
Odatiy ahamiyatlilik darajalari:
- \(\alpha = 0.1\) (10%)
- \(\alpha = 0.05\) (5%)
- \(\alpha = 0.01\) (1%)
Ahamiyatlilik darajasi pastroq bo‘lsa, nol gipotezani rad etish uchun ma’lumotlardagi dalillar kuchliroq bo‘lishi kerak.
"To‘g‘ri" ahamiyatlilik darajasi degan narsa yo‘q — u faqat xulosaning noaniqligini ko‘rsatadi.
Eslatma: 5% ahamiyatlilik darajasi shuni anglatadiki, nol gipotezani rad etganimizda:
Biz 100 martadan 5 tasida to‘g‘ri nol gipotezani rad etishimizni kutamiz.
4. Test statistikasini hisoblash
Test statistikasi gipoteza testining natijasini aniqlash uchun ishlatiladi.
Test statistikasi — tanlanmadan hisoblangan standartlashtirilgan qiymat.
Bosh to‘plam o‘rtachasi uchun test statistikasining (TS) formulasi:
\(\displaystyle \frac{\bar{x} - \mu}{s} \cdot \sqrt{n} \)
\(\bar{x}-\mu\) — tanlanma o‘rtachasi (\(\bar{x}\)) bilan da’vo qilingan bosh to‘plam o‘rtachasi (\(\mu\)) orasidagi farq.
\(s\) — tanlanma standart chetlanishi.
\(n\) — tanlanma hajmi.
Misolimizda:
The claimed (\(H_{0}\)) population mean (\(\mu\)) was \( 60 \)
The sample mean (\(\bar{x}\)) was \(62.1\)
The sample standard deviation (\(s\)) was \(13.46\)
The sample size (\(n\)) was \(30\)
Demak, test statistikasi (TS):
\(\displaystyle \frac{62.1-60}{13.46} \cdot \sqrt{30} = \frac{2.1}{13.46} \cdot \sqrt{30} \approx 0.156 \cdot 5.477 = \underline{0.855}\)
Test statistikasini dasturlash tili funksiyalari yordamida ham hisoblashingiz mumkin:
Misol
Python’da test statistikasini hisoblash uchun scipy va math kutubxonalaridan foydalaning.
import scipy.stats as stats
import math
# Specify the sample mean (x_bar), the sample standard deviation (s), the mean claimed in the null-hypothesis (mu_null), and the sample size (n)
x_bar = 62.1
s = 13.46
mu_null = 60
n = 30
# Calculate and print the test statistic
print((x_bar - mu_null)/(s/math.sqrt(n)))
O‘zingiz sinab ko‘ring »
Misol
R’da test statistikasini hisoblash uchun o‘rnatilgan matematik va statistik funksiyalardan foydalaning.
# Specify the sample mean (x_bar), the sample standard deviation (s), the mean claimed in the null-hypothesis (mu_null), and the sample size (n)
x_bar <- 62.1
s <- 13.46
mu_null <- 60
n <- 30
# Output the test statistic
(x_bar - mu_null)/(s/sqrt(n))
O‘zingiz sinab ko‘ring »
5. Xulosa chiqarish
Gipoteza testi bo‘yicha xulosa chiqarishning ikkita asosiy yondashuvi bor:
- Kritik qiymat yondashuvi test statistikasini ahamiyatlilik darajasining kritik qiymati bilan taqqoslaydi.
- P-qiymat yondashuvi test statistikasining P-qiymatini ahamiyatlilik darajasi bilan taqqoslaydi.
Eslatma: Ikki yondashuv faqat xulosani qanday taqdim etishi bilan farq qiladi.
Kritik qiymat yondashuvi
Kritik qiymat yondashuvi uchun ahamiyatlilik darajasining (\(\alpha\)) kritik qiymatini (CV) topishimiz kerak.
Bosh to‘plam o‘rtachasi testida kritik qiymat (CV) — Styudentning t-taqsimotidan olingan T-qiymat.
Bu kritik T-qiymat (CV) test uchun rad etish sohasini belgilaydi.
Rad etish sohasi — standart normal taqsimot dumlaridagi ehtimollik sohasi.
Da’vo bosh to‘plam o‘rtachasi 60 dan kamroq ekani haqida bo‘lgani uchun rad etish sohasi chap dumda joylashgan:
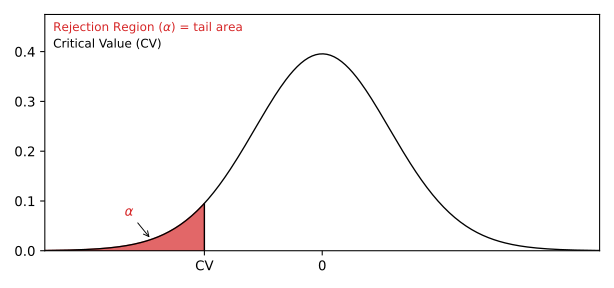
Rad etish sohasining kattaligi ahamiyatlilik darajasi (\(\alpha\)) bilan belgilanadi.
Styudentning t-taqsimoti kichikroq tanlanmalardan kelib chiqadigan noaniqlikka moslashtirilgan.
Bu moslashtirish erkinlik darajalari (df) deb ataladi va u tanlanma hajmi \((n) - 1\) ga teng
Bu holda erkinlik darajalari (df): \(30 - 1 = \underline{29} \)
Ahamiyatlilik darajasini (\(\alpha\)) 0.05, ya’ni 5% deb tanlab, kritik T-qiymatni T-jadvaldan yoki dasturlash tili funksiyasi yordamida topishimiz mumkin:
Misol
Python’da 29 erkinlik darajasida (df) \(\alpha\) = 0.05 uchun T-qiymatni topish uchun Scipy Stats kutubxonasining t.ppf() funksiyasidan foydalaning.
import scipy.stats as stats
print(stats.t.ppf(0.05, 29))
O‘zingiz sinab ko‘ring »
Misol
R’da 29 erkinlik darajasida (df) \(\alpha\) = 0.05 uchun t-qiymatni topish uchun o‘rnatilgan qt() funksiyasidan foydalaning.
qt(0.05, 29)
O‘zingiz sinab ko‘ring »
Istalgan usul yordamida kritik T-qiymat \(\approx \underline{-1.699}\) ga teng ekanini topishimiz mumkin
Chap tomonlama test uchun test statistikasi (TS) kritik qiymatdan (CV) kichik ekanini tekshirishimiz kerak.
Agar test statistikasi kritik qiymatdan kichik bo‘lsa, test statistikasi rad etish sohasida bo‘ladi.
Test statistikasi rad etish sohasida bo‘lsa, nol gipotezani (\(H_{0}\)) rad etamiz.
Bu yerda test statistikasi (TS) \(\approx \underline{0.855}\) ga, kritik qiymat esa \(\approx \underline{-1.699}\) ga teng edi
Mana bu testning grafikdagi tasviri:
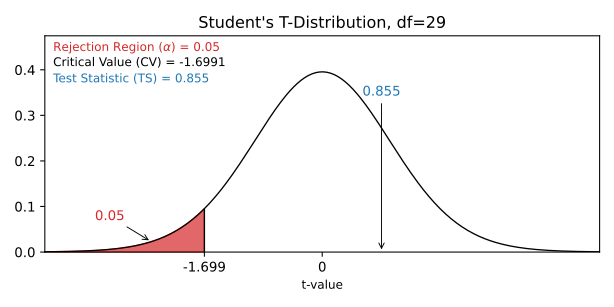
Test statistikasi kritik qiymatdan katta bo‘lgani uchun nol gipotezani saqlab qolamiz.
Bu tanlanma ma’lumotlari muqobil gipotezani qo‘llab-quvvatlamasligini bildiradi.
Xulosani quyidagicha umumlashtirishimiz mumkin:
The sample data does not support the claim that "The average age of Nobel Prize winners when they received the prize is less than 60" at a 5% significance level.
P-qiymat yondashuvi
P-qiymat yondashuvi uchun test statistikasining (TS) P-qiymatini topishimiz kerak.
Agar P-qiymat ahamiyatlilik darajasidan (\(\alpha\)) kichik bo‘lsa, nol gipotezani (\(H_{0}\)) rad etamiz.
Test statistikasi \( \approx \underline{0.855} \) ga teng ekani aniqlangan edi
Bosh to‘plam ulushi testida test statistikasi — Styudentning t-taqsimotidan olingan T-qiymat.
Bu chap tomonlama test bo‘lgani uchun 0.855 dan kichik t-qiymatning P-qiymatini topishimiz kerak.
Styudentning t-taqsimoti erkinlik darajalariga (df) qarab moslashtiriladi; ular tanlanma hajmi \((30) - 1 = \underline{29}\) ga teng
P-qiymatni T-jadval yordamida yoki dasturlash tili funksiyasi orqali topishimiz mumkin:
Misol
Python’da 29 erkinlik darajasida (df) 0.855 dan kichik T-qiymatning P-qiymatini topish uchun Scipy Stats kutubxonasining t.cdf() funksiyasidan foydalaning:
import scipy.stats as stats
print(stats.t.cdf(0.855, 29))
O‘zingiz sinab ko‘ring »
Misol
R’da 29 erkinlik darajasida (df) 0.855 dan kichik T-qiymatning P-qiymatini topish uchun o‘rnatilgan pt() funksiyasidan foydalaning:
pt(0.855, 29)
O‘zingiz sinab ko‘ring »
Istalgan usul yordamida P-qiymat \(\approx \underline{0.800}\) ga teng ekanini topishimiz mumkin
Bu nol gipotezani rad etish uchun ahamiyatlilik darajasi (\(\alpha\)) 0.80 dan, ya’ni 80% dan kichik bo‘lishi kerakligini ko‘rsatadi.
Mana bu testning grafikdagi tasviri:
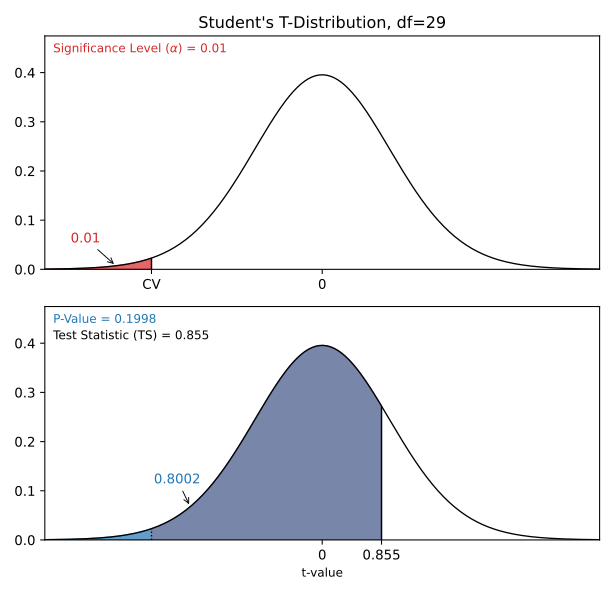
Bu P-qiymat odatiy ahamiyatlilik darajalarining (10%, 5%, 1%) har biridan ancha katta.
Shuning uchun bu ahamiyatlilik darajalarining barchasida nol gipoteza saqlab qolinadi.
Xulosani quyidagicha umumlashtirishimiz mumkin:
The sample data does not support the claim that "The average age of Nobel Prize winners when they received the prize is less than 60" at a 10%, 5%, or 1% significance level.
Gipoteza testi uchun P-qiymatni dasturlash yordamida hisoblash
Ko‘plab dasturlash tillari gipoteza testi natijasini aniqlash uchun P-qiymatni hisoblay oladi.
Statistikalarni hisoblash uchun dasturiy ta’minot va dasturlashdan foydalanish katta ma’lumotlar to‘plamlarida ko‘proq uchraydi, chunki qo‘lda hisoblash qiyinlashadi.
Bu yerda hisoblangan P-qiymat nol gipotezani rad etish mumkin bo‘lgan eng past ahamiyatlilik darajasini ko‘rsatadi.
Misol
Python’da o‘rtacha qiymat uchun chap tomonlama gipoteza testining P-qiymatini hisoblash uchun scipy va math kutubxonalaridan foydalaning.
Bu yerda tanlanma hajmi 30, tanlanma o‘rtachasi 62.1, tanlanma standart chetlanishi 13.46 ga teng, test esa o‘rtacha qiymat 60 dan kichik ekanini tekshiradi.
import scipy.stats as stats
import math
# Specify the sample mean (x_bar), the sample standard deviation (s), the mean claimed in the null-hypothesis (mu_null), and the sample size (n)
x_bar = 62.1
s = 13.46
mu_null = 60
n = 30
# Calculate the test statistic
test_stat = (x_bar - mu_null)/(s/math.sqrt(n))
# Output the p-value of the test statistic (left tailed test)
print(stats.t.cdf(test_stat, n-1))
O‘zingiz sinab ko‘ring »
Misol
R’da o‘rtacha qiymat uchun chap tomonlama gipoteza testining P-qiymatini topish uchun o‘rnatilgan matematik va statistik funksiyalardan foydalaning.
Bu yerda tanlanma hajmi 30, tanlanma o‘rtachasi 62.1, tanlanma standart chetlanishi 13.46 ga teng, test esa o‘rtacha qiymat 60 dan kichik ekanini tekshiradi.
# Specify the sample mean (x_bar), the sample standard deviation (s), the mean claimed in the null-hypothesis (mu_null), and the sample size (n)
x_bar <- 62.1
s <- 13.46
mu_null <- 60
n <- 30
# Calculate the test statistic
test_stat = (x_bar - mu_null)/(s/sqrt(n))
# P-value the p-value of the test statistic (left tailed test)
pt(test_stat, n-1)
O‘zingiz sinab ko‘ring »
Chap tomonlama va ikki tomonlama testlar
Bu chap tomonlama testga misol edi: unda muqobil gipoteza parametr nol gipoteza da’vosidan kichik ekanini da’vo qilgan.
Boshqa turlar uchun shunga o‘xshash bosqichma-bosqich qo‘llanmani bu yerda ko‘rishingiz mumkin:
W3Schools Pathfinder
Yutuqlaringizni kuzating – bu bepul!