

Bosh to‘plam ulushini baholash
Bosh to‘plam ulushi — bosh to‘plamning muayyan kategoriyaga tegishli qismi.
Bosh to‘plam ulushlarini baholash uchun ishonch oraliqlaridan foydalaniladi.
Bosh to‘plam ulushlarini baholash
Bosh to‘plam parametrini baholash uchun tanlanmadan olingan statistikadan foydalaniladi.
Parametr uchun eng ehtimolli qiymat — nuqtaviy baho.
Bundan tashqari, baholangan parametr uchun quyi chegara va yuqori chegarani hisoblashimiz mumkin.
Xatolik chegarasi — quyi va yuqori chegaralarning nuqtaviy bahodan farqi.
Quyi va yuqori chegaralar birgalikda ishonch oralig‘ini belgilaydi.
Ishonch oralig‘ini hisoblash
Ishonch oralig‘ini hisoblash uchun quyidagi bosqichlardan foydalaniladi:
- Shartlarni tekshirish
- Nuqtaviy bahoni topish
- Ishonch darajasini tanlash
- Xatolik chegarasini hisoblash
- Ishonch oralig‘ini hisoblash
Masalan:
- Bosh to‘plam: Nobel mukofoti sovrindorlari
- Kategoriya: Amerika Qo‘shma Shtatlarida tug‘ilganlar
Tanlanma olib, ulardan qanchasi AQShda tug‘ilganini ko‘rishimiz mumkin.
Tanlanma ma’lumotlari AQShda tug‘ilgan barcha Nobel mukofoti sovrindorlarining ulushini baholash uchun ishlatiladi.
30 nafar Nobel mukofoti sovrindorini tasodifiy tanlab, quyidagini aniqlashimiz mumkin:
6 out of 30 Nobel Prize winners in the sample were born in the US
Bu ma’lumotlardan quyidagi bosqichlar orqali ishonch oralig‘ini hisoblashimiz mumkin.
1. Shartlarni tekshirish
Ulush uchun ishonch oralig‘ini hisoblash shartlari:
- Tanlanma tasodifiy tanlangan
- Faqat ikkita variant bor:
- Kategoriyaga tegishli bo‘lish
- Kategoriyaga tegishli bo‘lmaslik
- Tanlanmada kamida quyidagilar bo‘lishi kerak:
- Kategoriyaga tegishli 5 ta a’zo
- Kategoriyaga tegishli bo‘lmagan 5 ta a’zo
Misolimizda tasodifiy tanlanganlardan 6 kishi AQShda tug‘ilgan.
Qolganlari AQShda tug‘ilmagan, shuning uchun boshqa kategoriyada 24 kishi bor.
Bu holda shartlar bajarilgan.
Eslatma: Har bir kategoriyada 5 tadan a’zo bo‘lmasa ham, ishonch oralig‘ini hisoblash mumkin. Lekin buning uchun maxsus tuzatishlar kiritish kerak.
2. Nuqtaviy bahoni topish
Nuqtaviy baho — tanlanma ulushi (\(\hat{p}\)).
Tanlanma ulushini hisoblash formulasi — uchrashlar sonining (\(x\)) tanlanma hajmiga (\(n\)) bo‘linmasi:
\(\displaystyle \hat{p} =\frac{x}{n}\)
Misolimizda 30 kishidan 6 tasi AQShda tug‘ilgan: \(x\) 6 ga, \(n\) esa 30 ga teng.
Demak, ulush uchun nuqtaviy baho:
\(\displaystyle \hat{p} = \frac{x}{n} = \frac{6}{30} = \underline{0.2} = 20\%\)
Demak, tanlanmaning 20 foizi AQShda tug‘ilgan.
3. Ishonch darajasini tanlash
Ishonch darajasi foiz yoki o‘nli kasr bilan ifodalanadi.
Masalan, agar ishonch darajasi 95% yoki 0.95 bo‘lsa:
U holda qolgan ehtimollik (\(\alpha\)): 5%, ya’ni 1 - 0.95 = 0.05.
Ko‘p ishlatiladigan ishonch darajalari:
- 90%, bunda \(\alpha\) = 0.1
- 95%, bunda \(\alpha\) = 0.05
- 99%, bunda \(\alpha\) = 0.01
Eslatma: 95% ishonch darajasi shuni anglatadiki, agar 100 ta turli tanlanma olib, har biri uchun ishonch oralig‘ini tuzsak:
Haqiqiy parametr o‘sha 100 martadan 95 tasida ishonch oralig‘i ichida bo‘ladi.
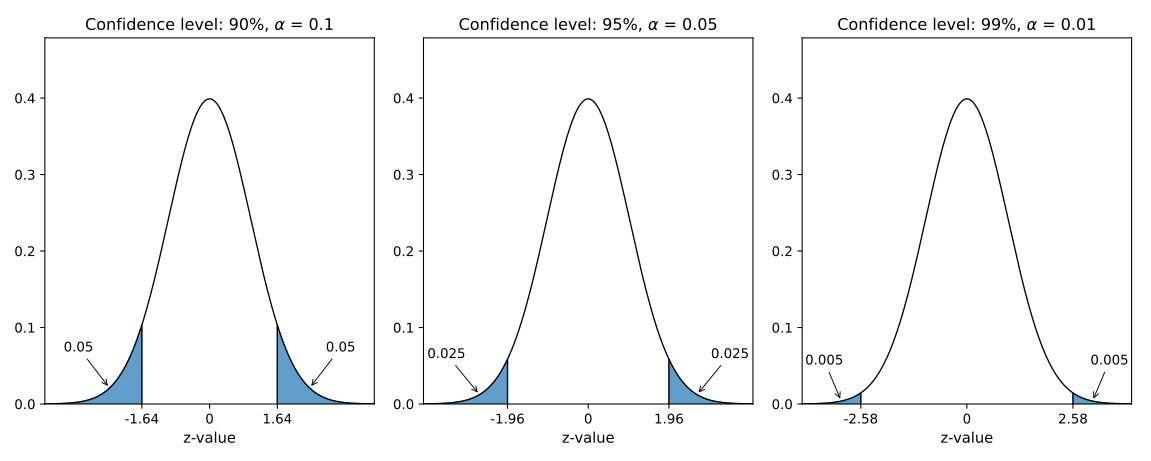
Ishonch oralig‘i uchun xatolik chegarasini topishda standart normal taqsimotdan foydalanamiz.
Qolgan ehtimolliklar (\(\alpha\)) ikkiga bo‘linadi, shunda uning yarmi taqsimotning har bir dum sohasiga to‘g‘ri keladi.
Z-qiymat o‘qidagi dum sohalarini o‘rta qismdan ajratib turadigan qiymatlar kritik z-qiymatlar deb ataladi.
Quyida turli ishonch darajalari uchun dum sohalarini (\(\alpha\)) ko‘rsatuvchi standart normal taqsimot grafiklari keltirilgan.
4. Xatolik chegarasini hisoblash
Xatolik chegarasi — nuqtaviy baho bilan quyi va yuqori chegaralar orasidagi farq.
Ulush uchun xatolik chegarasi (\(E\)) kritik z-qiymat va standart xatolik yordamida hisoblanadi:
\(\displaystyle E = Z_{\alpha/2} \cdot \sqrt{\frac{\hat{p}(1-\hat{p})}{n}} \)
Kritik z-qiymat \(Z_{\alpha/2} \) standart normal taqsimot va ishonch darajasidan hisoblanadi.
Standart xatolik \(\sqrt{\frac{\hat{p}(1-\hat{p})}{n}} \) nuqtaviy baho (\(\hat{p}\)) va tanlanma hajmidan (\(n\)) hisoblanadi.
30 kishilik tanlanmada AQShda tug‘ilgan 6 nafar Nobel mukofoti sovrindori bo‘lgan misolimizda standart xatolik:
\(\displaystyle \sqrt{\frac{\hat{p}(1-\hat{p})}{n}} = \sqrt{\frac{0.2(1-0.2)}{30}} = \sqrt{\frac{0.2 \cdot 0.8}{30}} = \sqrt{\frac{0.16}{30}} = \sqrt{0.00533..} \approx \underline{0.073}\)
Agar ishonch darajasi sifatida 95% ni tanlasak, \(\alpha\) 0.05 ga teng bo‘ladi.
Demak, \(Z_{0.05/2} = Z_{0.025}\) kritik z-qiymatini topishimiz kerak
Kritik z-qiymatni Z-jadval yordamida yoki dasturlash tili funksiyasi orqali topish mumkin:
Misol
Python’da \(\alpha\)/2 = 0.025 uchun Z-qiymatni topish uchun Scipy Stats kutubxonasining norm.ppf() funksiyasidan foydalaning
import scipy.stats as stats
print(stats.norm.ppf(1-0.025))
O‘zingiz sinab ko‘ring »
Misol
R’da \(\alpha\)/2 = 0.025 uchun Z-qiymatni topish uchun o‘rnatilgan qnorm() funksiyasidan foydalaning
qnorm(1-0.025)
O‘zingiz sinab ko‘ring »
Istalgan usul yordamida kritik Z-qiymat \( Z_{\alpha/2} \) \(\approx \underline{1.96} \) ga teng ekanini topishimiz mumkin
Standart xatolik \(\sqrt{\frac{\hat{p}(1-\hat{p})}{n}}\) \( \approx \underline{0.073}\) ga teng edi
Demak, xatolik chegarasi (\(E\)):
\(\displaystyle E = Z_{\alpha/2} \cdot \sqrt{\frac{\hat{p}(1-\hat{p})}{n}} \approx 1.96 \cdot 0.073 = \underline{0.143}\)
5. Ishonch oralig‘ini hisoblash
Ishonch oralig‘ining quyi va yuqori chegaralari nuqtaviy bahodan (\(\hat{p}\)) xatolik chegarasini (\(E\)) ayirish va unga qo‘shish orqali topiladi.
Misolimizda nuqtaviy baho 0.2, xatolik chegarasi esa 0.143 edi, u holda:
Quyi chegara:
\(\hat{p} - E = 0.2 - 0.143 = \underline{0.057} \)
Yuqori chegara:
\(\hat{p} + E = 0.2 + 0.143 = \underline{0.343} \)
Ishonch oralig‘i:
\([0.057, 0.343]\) yoki \([5.7 \%, 34.4 \%]\)
Ishonch oralig‘ini quyidagicha xulosalashimiz mumkin:
The 95% confidence interval for the proportion of Nobel Prize winners born in the US is between 5.7% and 34.4%
Ishonch oralig‘ini dasturlash yordamida hisoblash
Ishonch oralig‘ini ko‘plab dasturlash tillarida hisoblash mumkin.
Statistikalarni hisoblash uchun dasturiy ta’minot va dasturlashdan foydalanish katta ma’lumotlar to‘plamlarida ko‘proq uchraydi, chunki qo‘lda hisoblash qiyinlashadi.
Misol
Python’da baholangan ulush uchun ishonch oralig‘ini hisoblash uchun scipy va math kutubxonalaridan foydalaning.
Bu yerda tanlanma hajmi 30 ga, uchrashlar soni esa 6 ga teng.
import scipy.stats as stats
import math
# Specify sample occurrences (x), sample size (n) and confidence level
x = 6
n = 30
confidence_level = 0.95
# Calculate the point estimate, alpha, the critical z-value, the standard error, and the margin of error
point_estimate = x/n
alpha = (1-confidence_level)
critical_z = stats.norm.ppf(1-alpha/2)
standard_error = math.sqrt((point_estimate*(1-point_estimate)/n))
margin_of_error = critical_z * standard_error
# Calculate the lower and upper bound of the confidence interval
lower_bound = point_estimate - margin_of_error
upper_bound = point_estimate + margin_of_error
# Print the results
print("Point Estimate: {:.3f}".format(point_estimate))
print("Critical Z-value: {:.3f}".format(critical_z))
print("Margin of Error: {:.3f}".format(margin_of_error))
print("Confidence Interval: [{:.3f},{:.3f}]".format(lower_bound,upper_bound))
print("The {:.1%} confidence interval for the population proportion is:".format(confidence_level))
print("between {:.3f} and {:.3f}".format(lower_bound,upper_bound))
O‘zingiz sinab ko‘ring »
Misol
R’da baholangan ulush uchun ishonch oralig‘ini hisoblash uchun o‘rnatilgan matematik va statistik funksiyalardan foydalaning.
Bu yerda tanlanma hajmi 30 ga, uchrashlar soni esa 6 ga teng.
# Specify sample occurrences (x), sample size (n) and confidence level
x = 6
n = 30
confidence_level = 0.95
# Calculate the point estimate, alpha, the critical z-value, the standard error, and the margin of error
point_estimate = x/n
alpha = (1-confidence_level)
critical_z = qnorm(1-alpha/2)
standard_error = sqrt(point_estimate*(1-point_estimate)/n)
margin_of_error = critical_z * standard_error
# Calculate the lower and upper bound of the confidence interval
lower_bound = point_estimate - margin_of_error
upper_bound = point_estimate + margin_of_error
# Print the results
sprintf("Point Estimate: %0.3f", point_estimate)
sprintf("Critical Z-value: %0.3f", critical_z)
sprintf("Margin of Error: %0.3f", margin_of_error)
sprintf("Confidence Interval: [%0.3f,%0.3f]", lower_bound, upper_bound)
sprintf("The %0.1f%% confidence interval for the population proportion is:", confidence_level*100)
sprintf("between %0.4f and %0.4f", lower_bound, upper_bound)
O‘zingiz sinab ko‘ring »
W3Schools Pathfinder
Yutuqlaringizni kuzating – bu bepul!