

O‘qitish/test
Modelingizni baholang
Mashinani o‘rganishda biz ma’lum hodisalarning natijalarini bashorat qilish uchun modellar yaratamiz, masalan, oldingi bobda biz og‘irligi va dvigatel hajmini bilganimizda avtomobilning CO2 emissiyasini bashorat qilgan edik.
Model yetarlicha yaxshi yoki yo‘qligini o‘lchash uchun biz Train/Test deb nomlangan usuldan foydalanishimiz mumkin.
Train/Test nima
Train/Test - bu modelingizning aniqligini o‘lchash usuli.
U Train/Test deb ataladi, chunki siz ma’lumotlar to‘plamini ikkita setga ajratasiz: o‘quv to‘plami va test to‘plami.
80% trening uchun, 20% esa test uchun.
Siz o‘quv majmuasi yordamida modelni o‘rgatasiz.
Siz modelni sinov to‘plamidan foydalanib sinab ko‘rasiz.
Modelni o‘rgatish - bu modelni yaratish.
Modelni sinab ko‘rish - modelning aniqligini tekshirish.
Ma’lumotlar to‘plamidan boshlang
Sinov qilmoqchi bo‘lgan ma’lumotlar to‘plamidan boshlang.
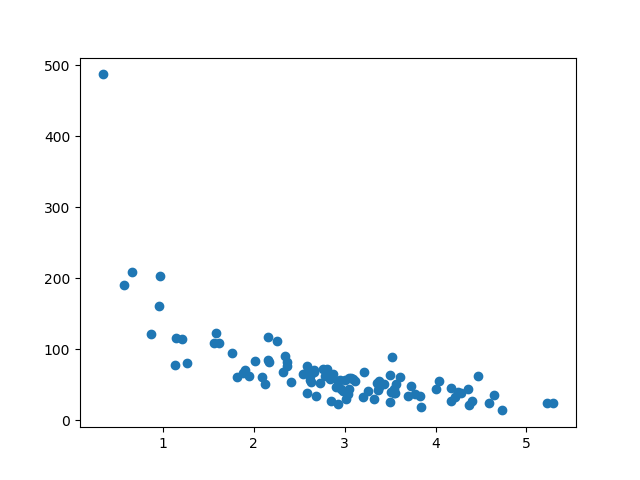
Bizning ma’lumotlar to‘plamimiz do‘kondagi 100 ta xaridorni va ularning xarid qilish odatlarini ko‘rsatadi.
Misol
import numpy
import matplotlib.pyplot as plt
numpy.random.seed(2)
x = numpy.random.normal(3, 1, 100)
y = numpy.random.normal(150, 40, 100) / x
plt.scatter(x, y)
plt.show()
Natija:
X o‘qi xarid qilishdan oldingi daqiqalar sonini bildiradi.
Y o‘qi xaridga sarflangan pul miqdorini ifodalaydi.
Train’ga/Testga bo‘linish
O‘quv majmuasi dastlabki ma’lumotlarning 80% tasodifiy tanlovi bo‘lishi kerak.
Sinov to‘plami qolgan 20% bo‘lishi kerak.
train_x = x[:80]

train_y = y[:80]


test_x = x[80:]

test_y = y[80:]
Trening to‘plamini ko‘rsatish
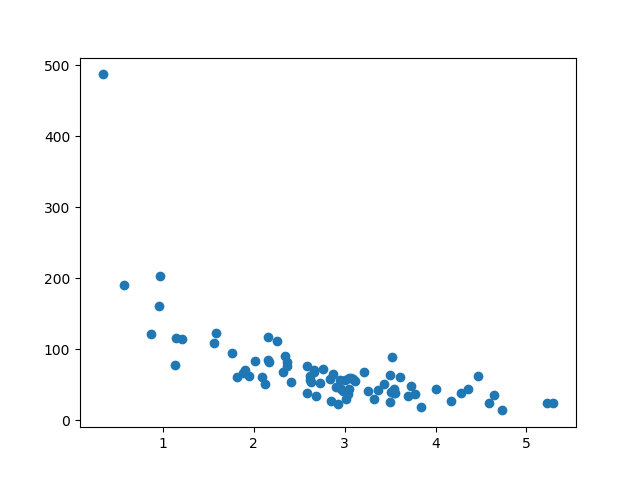
Trening to‘plami bilan bir xil tarqalish sxemasini ko‘rsating:
Misol
plt.scatter(train_x, train_y)
plt.show()
Natija:
Bu asl ma’lumotlar to‘plamiga o‘xshaydi, shuning uchun bu adolatli tanlov kabi ko‘rinadi:
Sinov to‘plamini ko‘rsatish
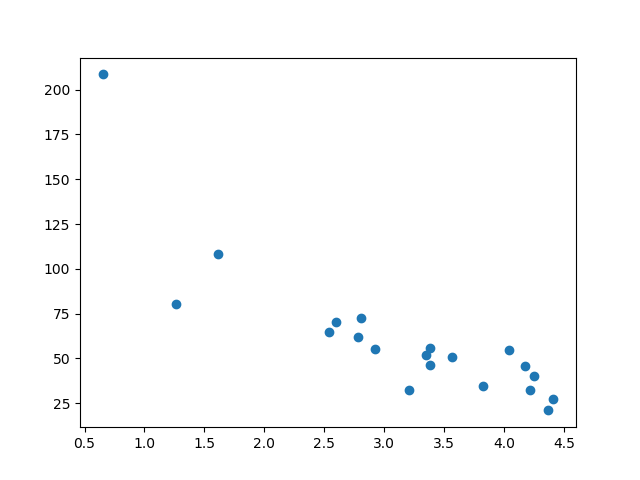
Sinov to‘plami butunlay boshqacha emasligiga ishonch hosil qilish uchun biz sinov to‘plamini ham ko‘rib chiqamiz.
Misol
plt.scatter(test_x, test_y)
plt.show()
Natija:
Sinov to‘plami ham asl ma’lumotlar to‘plamiga o‘xshaydi:
Ma’lumotlar to‘plamini moslang
Ma’lumotlar to‘plami qanday ko‘rinishga ega? Menimcha, polinom regressiyasi eng yaxshi mos keladi, shuning uchun polinom regressiyasi chizig‘ini chizamiz.
Ma’lumotlar nuqtalari orqali chiziq chizish uchun biz matplotlib modulining plot() usulidan foydalanamiz:
Misol
Ma’lumotlar nuqtalari orqali polinom regressiya chizig‘ini chizing:
import numpy
import matplotlib.pyplot as plt
numpy.random.seed(2)
x = numpy.random.normal(3, 1, 100)
y = numpy.random.normal(150, 40, 100) / x
train_x = x[:80]
train_y = y[:80]
test_x = x[80:]
test_y = y[80:]
mymodel = numpy.poly1d(numpy.polyfit(train_x, train_y, 4))
myline = numpy.linspace(0, 6, 100)
plt.scatter(train_x, train_y)
plt.plot(myline, mymodel(myline))
plt.show()
Natija:
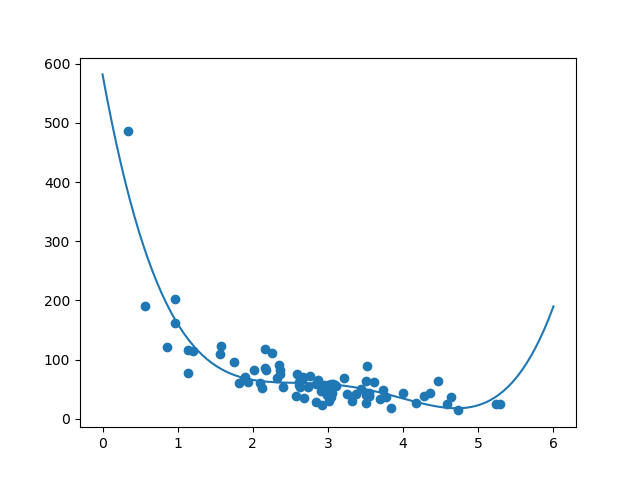
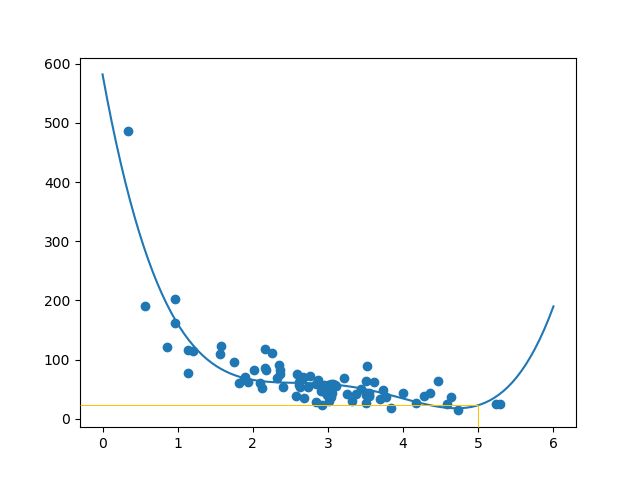
Natija polinomli regressiyaga mos keladigan ma’lumotlar to‘plami haqidagi taklifimni qaytarishi mumkin, garchi biz ma’lumotlar to‘plamidan tashqari qiymatlarni taxmin qilishga harakat qilsak, bu bizga g‘alati natijalar beradi. Misol: chiziq do‘konda 6 daqiqa vaqt sarflagan mijoz 200 ga xarid qilishini bildiradi. Bu, ehtimol, haddan tashqari moslashish belgisidir.
Lekin R-kvadrat ball haqida nima deyish mumkin? R-kvadrat ball mening ma’lumotlar to‘plamim modelga qanchalik mos kelishining yaxshi ko‘rsatkichidir.
R2
R-kvadrat sifatida ham tanilgan R2 esingizdami?
U x o‘qi va y o‘qi o‘rtasidagi munosabatni o‘lchaydi va qiymat 0 dan 1 gacha, bu yerda 0 aloqa yo‘q, 1 esa butunlay bog‘liq degan ma’noni anglatadi.
Sklearn modulida bu munosabatni topishga yordam beradigan r2_score() deb nomlangan usul mavjud.
Bunday holda, mijozning do‘konda qolgan daqiqalari va qancha pul sarflashi o‘rtasidagi munosabatni o‘lchashni xohlaymiz.
Misol
Mening mashg‘ulot ma’lumotlarim polinomli regressiyaga qanchalik mos keladi?
import numpy
from sklearn.metrics import r2_score
numpy.random.seed(2)
x = numpy.random.normal(3, 1, 100)
y = numpy.random.normal(150, 40, 100) / x
train_x = x[:80]
train_y = y[:80]
test_x = x[80:]
test_y = y[80:]
mymodel = numpy.poly1d(numpy.polyfit(train_x, train_y, 4))
r2 = r2_score(train_y, mymodel(train_x))
print(r2)
O‘zingiz sinab ko‘ring »
Eslatma: Natija 0,799 OK munosabati borligini ko‘rsatadi.
Sinov to‘plamini olib keling
Endi biz hech bo‘lmaganda mashg‘ulot ma’lumotlariga kelganda yaxshi bo‘lgan modelni yaratdik.
Endi biz modelni sinov ma’lumotlari bilan ham sinab ko‘rmoqchimiz, xuddi shunday natija beradimi yoki yo‘qmi.
Misol
Sinov ma’lumotlaridan foydalanganda R2 ballini topamiz:
import numpy
from sklearn.metrics import r2_score
numpy.random.seed(2)
x = numpy.random.normal(3, 1, 100)
y = numpy.random.normal(150, 40, 100) / x
train_x = x[:80]
train_y = y[:80]
test_x = x[80:]
test_y = y[80:]
mymodel = numpy.poly1d(numpy.polyfit(train_x, train_y, 4))
r2 = r2_score(test_y, mymodel(test_x))
print(r2)
O‘zingiz sinab ko‘ring »
Eslatma: Natija 0.809 model sinov to‘plamiga ham mos kelishini ko‘rsatadi va biz kelajakdagi qiymatlarni bashorat qilish uchun modeldan foydalanishimiz mumkinligiga aminmiz.
Qiymatlarni bashorat qilish
Endi biz modelimiz yaxshi ekanligini aniqlaganimizdan so‘ng, biz yangi qiymatlarni bashorat qilishni boshlashimiz mumkin.
Misol
Xarid qilayotgan mijoz do‘konda 5 daqiqa tursa, qancha pul sarflaydi?
print(mymodel(5))
Misolni ishga tushirish »
Misol mijozning 22,88 dollar sarflashini taxmin qildi, chunki diagrammaga mos keladi:
W3Schools Pathfinder
Yutuqlaringizni kuzating – bu bepul!