

K-means
K- degani
K-means - bu ma’lumotlar nuqtalarini klasterlash uchun nazoratsiz o‘rganish usuli. Algoritm iterativ ravishda ma’lumotlar nuqtalarini har bir klasterdagi tafovutni minimallashtirish orqali K klasterlariga ajratadi.
Bu yerda biz tirsak usuli yordamida K uchun eng yaxshi qiymatni qanday baholashni ko‘rsatamiz, so‘ngra ma’lumotlar nuqtalarini klasterlarga guruhlash uchun K-means klasterlashdan foydalaning.
U qanday ishlaydi?
Birinchidan, har bir ma’lumot nuqtasi tasodifiy ravishda K klasterlaridan biriga tayinlanadi. Keyin, biz har bir klasterning markaziy qismini (funktsional ravishda markaz) hisoblaymiz va har bir ma’lumot nuqtasini eng yaqin markazga ega bo‘lgan klasterga qayta tayinlaymiz. Har bir ma’lumot nuqtasi uchun klaster tayinlashlari o‘zgarmaguncha ushbu jarayonni takrorlaymiz.
K-klasterlash bizdan K ni tanlashni talab qiladi, ya’ni biz ma’lumotlarni guruhlashtirmoqchi bo‘lgan klasterlar sonini. Tirsak usuli bizga inertsiya (masofaga asoslangan metrik) grafigini tuzish va uning chiziqli ravishda kamayib borayotgan nuqtasini tasavvur qilish imkonini beradi. Bu nuqta "tirsak" deb ataladi va bizning ma’lumotlarimiz asosida K uchun eng yaxshi qiymat uchun yaxshi bahodir.
Misol
Ba’zi ma’lumotlar nuqtalarini vizualizatsiya qilishdan boshlang:
import matplotlib.pyplot as plt
x = [4, 5, 10, 4, 3, 11, 14 , 6, 10, 12]
y = [21, 19, 24, 17, 16, 25, 24, 22, 21, 21]
plt.scatter(x, y)
plt.show()
Natija
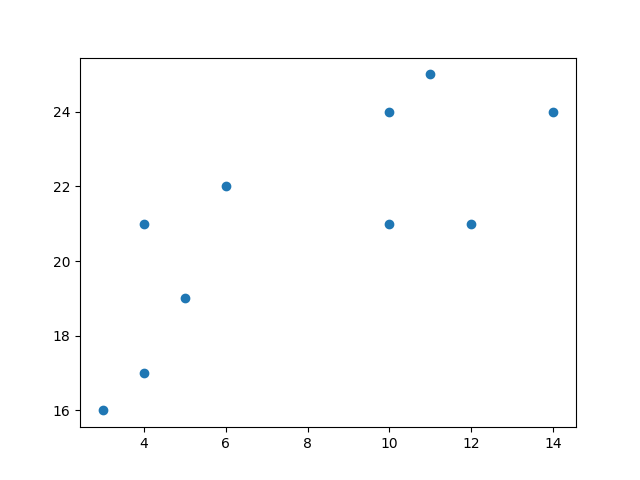
Endi biz K ning turli qiymatlari uchun intertialarni tasavvur qilish uchun tirsak usulidan foydalanamiz:
Misol
from sklearn.cluster import KMeans
data = list(zip(x, y))
inertias = []
for i in range(1,11):
kmeans = KMeans(n_clusters=i)
kmeans.fit(data)
inertias.append(kmeans.inertia_)
plt.plot(range(1,11), inertias, marker='o')
plt.title('Elbow method')
plt.xlabel('Number of clusters')
plt.ylabel('Inertia')
plt.show()
Natija
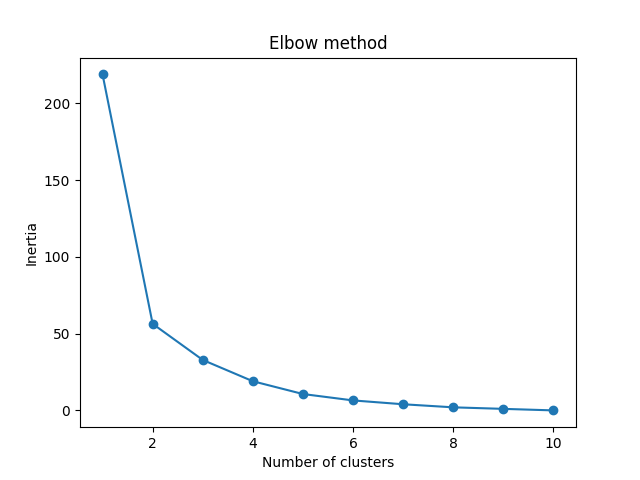
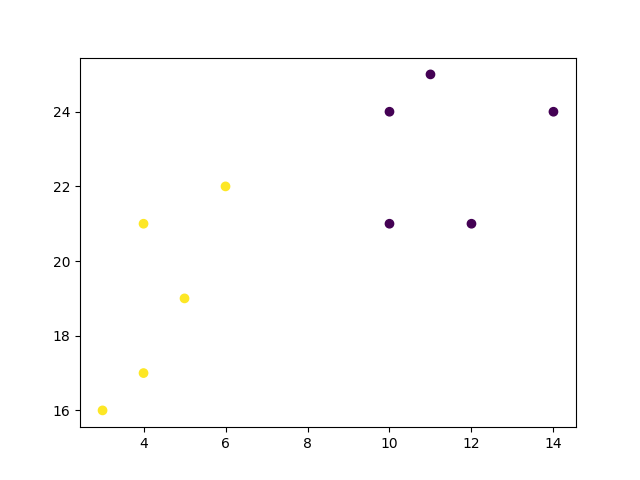
Tirsak usuli 2 ning K uchun yaxshi qiymat ekanligini ko‘rsatadi, shuning uchun biz qayta o‘qitamiz va natijani tasavvur qilamiz:
Misol
kmeans = KMeans(n_clusters=2)
kmeans.fit(data)
plt.scatter(x, y, c=kmeans.labels_)
plt.show()
Natija
Misol tushuntirildi
Sizga kerak bo‘lgan modullarni import qiling.
import matplotlib.pyplot as plt

from sklearn.cluster import KMeans
Matplotlib moduli haqida bizning "Matplotlib o‘quv qo‘llanmamizdan bilib olishingiz mumkin.
scikit-learn - bu mashinani o‘rganish uchun mashhur kutubxona.
Ma’lumotlar to‘plamida ikkita o‘zgaruvchiga o‘xshash massivlarni yarating. E’tibor bering, biz bu yerda faqat ikkita o‘zgaruvchidan foydalansak ham, bu usul istalgan miqdordagi o‘zgaruvchilar bilan ishlaydi:
x = [4, 5, 10, 4, 3, 11, 14 , 6, 10, 12]

y = [21, 19, 24, 17, 16, 25, 24, 22, 21, 21]
Ma’lumotlarni nuqtalar to‘plamiga aylantiring:
data = list(zip(x, y))

print(data)
Natija:
[(4, 21), (5, 19), (10, 24), (4, 17), (3, 16), (11, 25), (14, 24), (6, 22), (10, 21), (12, 21)]
K uchun eng yaxshi qiymatni topish uchun biz bir qator mumkin bo‘lgan qiymatlar uchun ma’lumotlarimiz bo‘ylab K-vositalarini ishlatishimiz kerak. Bizda bor-yo‘g‘i 10 ta ma’lumot nuqtasi bor, shuning uchun klasterlarning maksimal soni 10 ta. Shunday qilib, (1,11) diapazondagi har bir K qiymati uchun biz K-o‘rtacha modelini o‘rgatamiz va klasterlar soni bo‘yicha intervallarni chizamiz:
inertias = []


for i in range(1,11):

    kmeans = KMeans(n_clusters=i)

    kmeans.fit(data)

    inertias.append(kmeans.inertia_)


plt.plot(range(1,11), inertias, marker='o')

plt.title('Elbow method')

plt.xlabel('Number of clusters')

plt.ylabel('Inertia')

plt.show()
Natija:
Yuqoridagi grafikdagi "tirsak" (bu yerda interia yanada chiziqli bo‘ladi) K=2 da ekanligini ko‘rishimiz mumkin. Keyin biz K-means algoritmimizni yana bir bor moslashtiramiz va ma’lumotlarga tayinlangan turli klasterlarni chizamiz:
kmeans = KMeans(n_clusters=2)

kmeans.fit(data)


plt.scatter(x, y, c=kmeans.labels_)

plt.show()
Natija:
W3Schools Pathfinder
Yutuqlaringizni kuzating – bu bepul!