

Bootstrap agregatsiya (bagging)
Qoplash
Qaror daraxtlari kabi usullar o‘quv majmuasiga haddan tashqari moslashishga moyil bo‘lishi mumkin, bu esa yangi ma’lumotlar bo‘yicha noto‘g‘ri prognozlarga olib kelishi mumkin.
Bootstrap Aggregation (bagging) klassifikatsiya yoki regressiya masalalarida ortiqcha moslashish (overfitting) muammosini hal qilishga harakat qiladigan ansambl usulidir. Bagging mashinaviy o‘qitish algoritmlarining aniqligi va samaradorligini oshirishga qaratilgan. Buning uchun u asl ma’lumotlar to‘plamidan qaytarib qo‘yish bilan tasodifiy qism to‘plamlar oladi va har bir qism to‘plamga klassifikator (klassifikatsiya uchun) yoki regressor (regressiya uchun) moslaydi. So‘ngra har bir qism to‘plam bo‘yicha bashoratlar klassifikatsiyada ko‘pchilik ovozi, regressiyada esa o‘rtachalash orqali birlashtiriladi va bu bashorat aniqligini oshiradi.
Bazaviy klassifikatorni baholash
Qoplash modelning ishlashini qanday yaxshilashini ko‘rish uchun biz asosiy tasniflagichning ma’lumotlar to‘plamida qanday ishlashini baholashdan boshlashimiz kerak. Agar qaror daraxtlari qanday ekanligini bilmasangiz, oldinga siljishdan oldin qaror daraxtlari bo‘yicha darsni ko‘rib chiqing, chunki sumkalash kontseptsiyaning davomidir.
Biz Sklearnning sharob ma’lumotlar to‘plamida topilgan sharoblarning turli sinflarini aniqlashga harakat qilamiz.
Let’s start by importing the necessary modules.from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.tree import DecisionTreeClassifier
Keyinchalik biz ma’lumotlarni yuklashimiz va uni X (kirish xususiyatlari) va y (maqsad) ga saqlashimiz kerak.as_frame parametri True ga teng bo‘lib o‘rnatiladi, shuning uchun biz ma’lumotlarni yuklashda xususiyat nomlarini yo‘qotmaymiz. (sklearn versiyasi 0,23 dan eski as_frame argumentini o‘tkazib yuborishi kerak, chunki u qo‘llab-quvvatlanmaydi)
data = datasets.load_wine(as_frame = True)
X = data.data
y = data.target
Ko‘rinmas ma’lumotlar bo‘yicha modelimizni to‘g‘ri baholash uchun biz X va y ni poezd va test to‘plamlariga bo‘lishimiz kerak. Ma’lumotlarni bo‘lish haqida ma’lumot olish uchun Train/Test darsiga qarang.
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size = 0.25, random_state = 22)
Tayyorlangan ma’lumotlarimiz bilan biz endi asosiy tasniflagichni yaratishimiz va uni o‘quv ma’lumotlariga moslashimiz mumkin.
dtree = DecisionTreeClassifier(random_state = 22)
dtree.fit(X_train,y_train)
Natija:
DecisionTreeClassifier(random_state=22)
Endi biz ko‘rinmas sinov to‘plamining sharob sinfini taxmin qilishimiz va modelning ishlashini baholashimiz mumkin.
y_pred = dtree.predict(X_test)
print("Train data accuracy:",accuracy_score(y_true = y_train, y_pred = dtree.predict(X_train)))
print("Test data accuracy:",accuracy_score(y_true = y_test, y_pred = y_pred))
Natija:
Train data accuracy: 1.0
Test data accuracy: 0.8222222222222222
Misol
Kerakli ma’lumotlarni import qiling va asosiy tasniflagichning ishlashini baholang.
from sklearn import datasets

from sklearn.model_selection import train_test_split

from sklearn.metrics import accuracy_score

from sklearn.tree import DecisionTreeClassifier
data = datasets.load_wine(as_frame = True)


X = data.data

y = data.target
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size = 0.25, random_state = 22)
dtree = DecisionTreeClassifier(random_state = 22)

dtree.fit(X_train,y_train)
y_pred = dtree.predict(X_test)


print("Train data accuracy:",accuracy_score(y_true = y_train, y_pred = dtree.predict(X_train)))

print("Test data accuracy:",accuracy_score(y_true = y_test, y_pred = y_pred))
Misolni ishga tushirish »
Asosiy klassifikator ma’lumotlar to‘plamida juda yaxshi ishlaydi va joriy parametrlar bilan test ma’lumotlar to‘plamida 82% aniqlikka erishadi (Agar sizda random_state parametrlar to‘plami bo‘lmasa, turli natijalar paydo bo‘lishi mumkin).
Endi bizda test ma’lumotlar to‘plamining asosiy aniqligi bor, biz Bagging klassifikatori bitta qaror daraxti tasniflagichini qanday bajarishini ko‘rishimiz mumkin.
Qoplash klassifikatorini yaratish
To‘plash uchun biz n_estimators parametrini o‘rnatishimiz kerak, bu bizning modelimiz birgalikda yig‘iladigan asosiy tasniflagichlar soni.
Ushbu namunaviy ma’lumotlar to‘plami uchun baholovchilar soni nisbatan kam, ko‘pincha kattaroq diapazonlar o‘rganiladi. Giperparametrlarni sozlash odatda grid qidiruvi bilan amalga oshiriladi, ammo hozircha biz hisoblagichlar soni uchun tanlangan qiymatlar to‘plamidan foydalanamiz.
Biz kerakli modelni import qilishdan boshlaymiz.
from sklearn.ensemble import BaggingClassifier
Keling, har bir ansamblda foydalanmoqchi bo‘lgan hisoblagichlar sonini ifodalovchi qiymatlar qatorini yarataylik.
estimator_range = [2,4,6,8,10,12,14,16]
Bagging klassifikatori n_estimators ning turli qiymatlari bilan qanday ishlashini ko‘rish uchun bizga qiymatlar oralig‘ida takrorlash va har bir ansambl natijalarini saqlash usuli kerak. Buni amalga oshirish uchun biz modellar va ballarni keyinchalik vizualizatsiya qilish uchun alohida listlarda saqlaydigan for siklini yaratamiz.
Eslatma:BaggingClassifierda asosiy klassifikator uchun standart parametr DecisionTreeClassifier hisoblanadi, shuning uchun biz sumka modelini yaratishda uni o‘rnatishimiz shart emas.
models = []

scores = []


for n_estimators in estimator_range:


    # Create bagging classifier

    clf = BaggingClassifier(n_estimators = n_estimators, random_state = 22)


    # Fit the model

    clf.fit(X_train, y_train)


    # Append the model and score to their respective list

    models.append(clf)

    scores.append(accuracy_score(y_true = y_test, y_pred = clf.predict(X_test)))
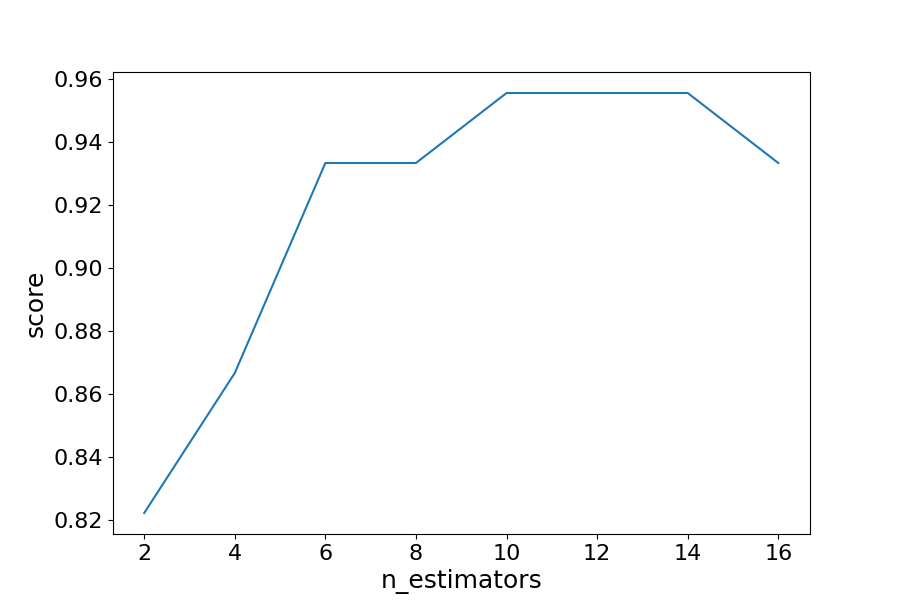
Saqlangan modellar va ballar bilan biz endi model ishlashining yaxshilanishini tasavvur qilishimiz mumkin.
import matplotlib.pyplot as plt


# Generate the plot of scores against number of estimators

plt.figure(figsize=(9,6))

plt.plot(estimator_range, scores)


# Adjust labels and font (to make visable)

plt.xlabel("n_estimators", fontsize = 18)

plt.ylabel("score", fontsize = 18)

plt.tick_params(labelsize = 16)


# Visualize plot

plt.show()
Misol
Kerakli ma’lumotlarni import qiling va BaggingClassifier unumdorlikni baholang.
import matplotlib.pyplot as plt
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.ensemble import BaggingClassifier
data = datasets.load_wine(as_frame = True)
X = data.data
y = data.target
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size = 0.25, random_state = 22)
estimator_range = [2,4,6,8,10,12,14,16]
models = []
scores = []
for n_estimators in estimator_range:
# Create bagging classifier
clf = BaggingClassifier(n_estimators = n_estimators, random_state = 22)
# Fit the model
clf.fit(X_train, y_train)
# Append the model and score to their respective list
models.append(clf)
scores.append(accuracy_score(y_true = y_test, y_pred = clf.predict(X_test)))
# Generate the plot of scores against number of estimators
plt.figure(figsize=(9,6))
plt.plot(estimator_range, scores)
# Adjust labels and font (to make visable)
plt.xlabel("n_estimators", fontsize = 18)
plt.ylabel("score", fontsize = 18)
plt.tick_params(labelsize = 16)
# Visualize plot
plt.show()
Natija
Natijalar tushuntirildi
Baholovchilar soni uchun turli qiymatlarni takrorlash orqali biz model unumdorligining 82,2% dan 95,5% gacha o‘sishini ko‘rishimiz mumkin. 14 ta hisoblagichdan so‘ng aniqlik pasaya boshlaydi, agar siz boshqa random_stateni o‘rnatsangiz, siz ko‘rgan qiymatlar o‘zgaradi. Shuning uchun barqaror natijalarni ta’minlash uchun o‘zaro tekshirishdan foydalanish eng yaxshi amaliyotdir.
Bunday holda, biz vino turini aniqlashda aniqlikning 13,3% ga oshganini ko‘ramiz.
Boshqa baholash shakli
Bootstrapping klassifikatorlarni yaratish uchun kuzatuvlarning tasodifiy kichik to‘plamlarini tanlaganligi sababli, tanlov jarayonida qoldirilmagan kuzatuvlar mavjud. Keyinchalik ushbu "qopdan tashqari" kuzatuvlar test to‘plamiga o‘xshash modelni baholash uchun ishlatilishi mumkin. Yodda tutingki, paketdan tashqari baholash ikkilik tasniflash muammolaridagi xatoni ortiqcha baholashi mumkin va faqat boshqa ko‘rsatkichlarga iltifot sifatida ishlatilishi kerak.
Oxirgi mashqda biz 12 ta hisoblagich eng yuqori aniqlikni berganini ko‘rdik, shuning uchun biz modelimizni yaratish uchun undan foydalanamiz. Bu safar modelni sumkadan tashqari ball bilan baholash uchun oob_score parametrini rostga o‘rnating.
Misol
Xaltadan tashqari metrikaga ega model yarating.
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.ensemble import BaggingClassifier
data = datasets.load_wine(as_frame = True)
X = data.data
y = data.target
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size = 0.25, random_state = 22)
oob_model = BaggingClassifier(n_estimators = 12, oob_score = True,random_state = 22)
oob_model.fit(X_train, y_train)
print(oob_model.oob_score_)
Misolni ishga tushirish »
OOBda ishlatiladigan namunalar va test to‘plami boshqacha bo‘lgani uchun va ma’lumotlar to‘plami nisbatan kichik bo‘lgani uchun aniqlikda farq bor. Ularning bir xil bo‘lishi kamdan-kam uchraydi, yana OOB xatoni baholash uchun tezkor vositadan foydalanish kerak, ammo yagona baholash ko‘rsatkichi emas.
Bagging klassifikatoridan qaror daraxtlarini yaratish
Qaror daraxti darsida ko‘rinib turganidek, model yaratilgan qarorlar daraxtining grafigini tuzish mumkin. Shuningdek, yig‘ilgan tasniflagichga kirgan individual qaror daraxtlarini ko‘rish mumkin. Bu bizga qadoqlash modeli o‘z bashoratlariga qanday erishishi haqida ko‘proq intuitiv tushunishga yordam beradi.
Eslatma: Bu faqat kichikroq ma’lumotlar to‘plamlari bilan ishlaydi, bu yerda daraxtlar nisbatan sayoz va tor bo‘lib, ularni vizualizatsiya qilish oson.
Biz sklearn.treedan plot_tree funksiyasini import qilishimiz kerak. Siz tasavvur qilmoqchi bo‘lgan smetachini o‘zgartirish orqali turli xil daraxtlarning grafiklarini chizishingiz mumkin.
Misol
Bagging klassifikatoridan qaror daraxtlarini yarating
from sklearn import datasets
from sklearn.model_selection import train_test_split
from sklearn.ensemble import BaggingClassifier
from sklearn.tree import plot_tree
X = data.data
y = data.target
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size = 0.25, random_state = 22)
clf = BaggingClassifier(n_estimators = 12, oob_score = True,random_state = 22)
clf.fit(X_train, y_train)
plt.figure(figsize=(30, 20))
plot_tree(clf.estimators_[0], feature_names = X.columns)
Natija
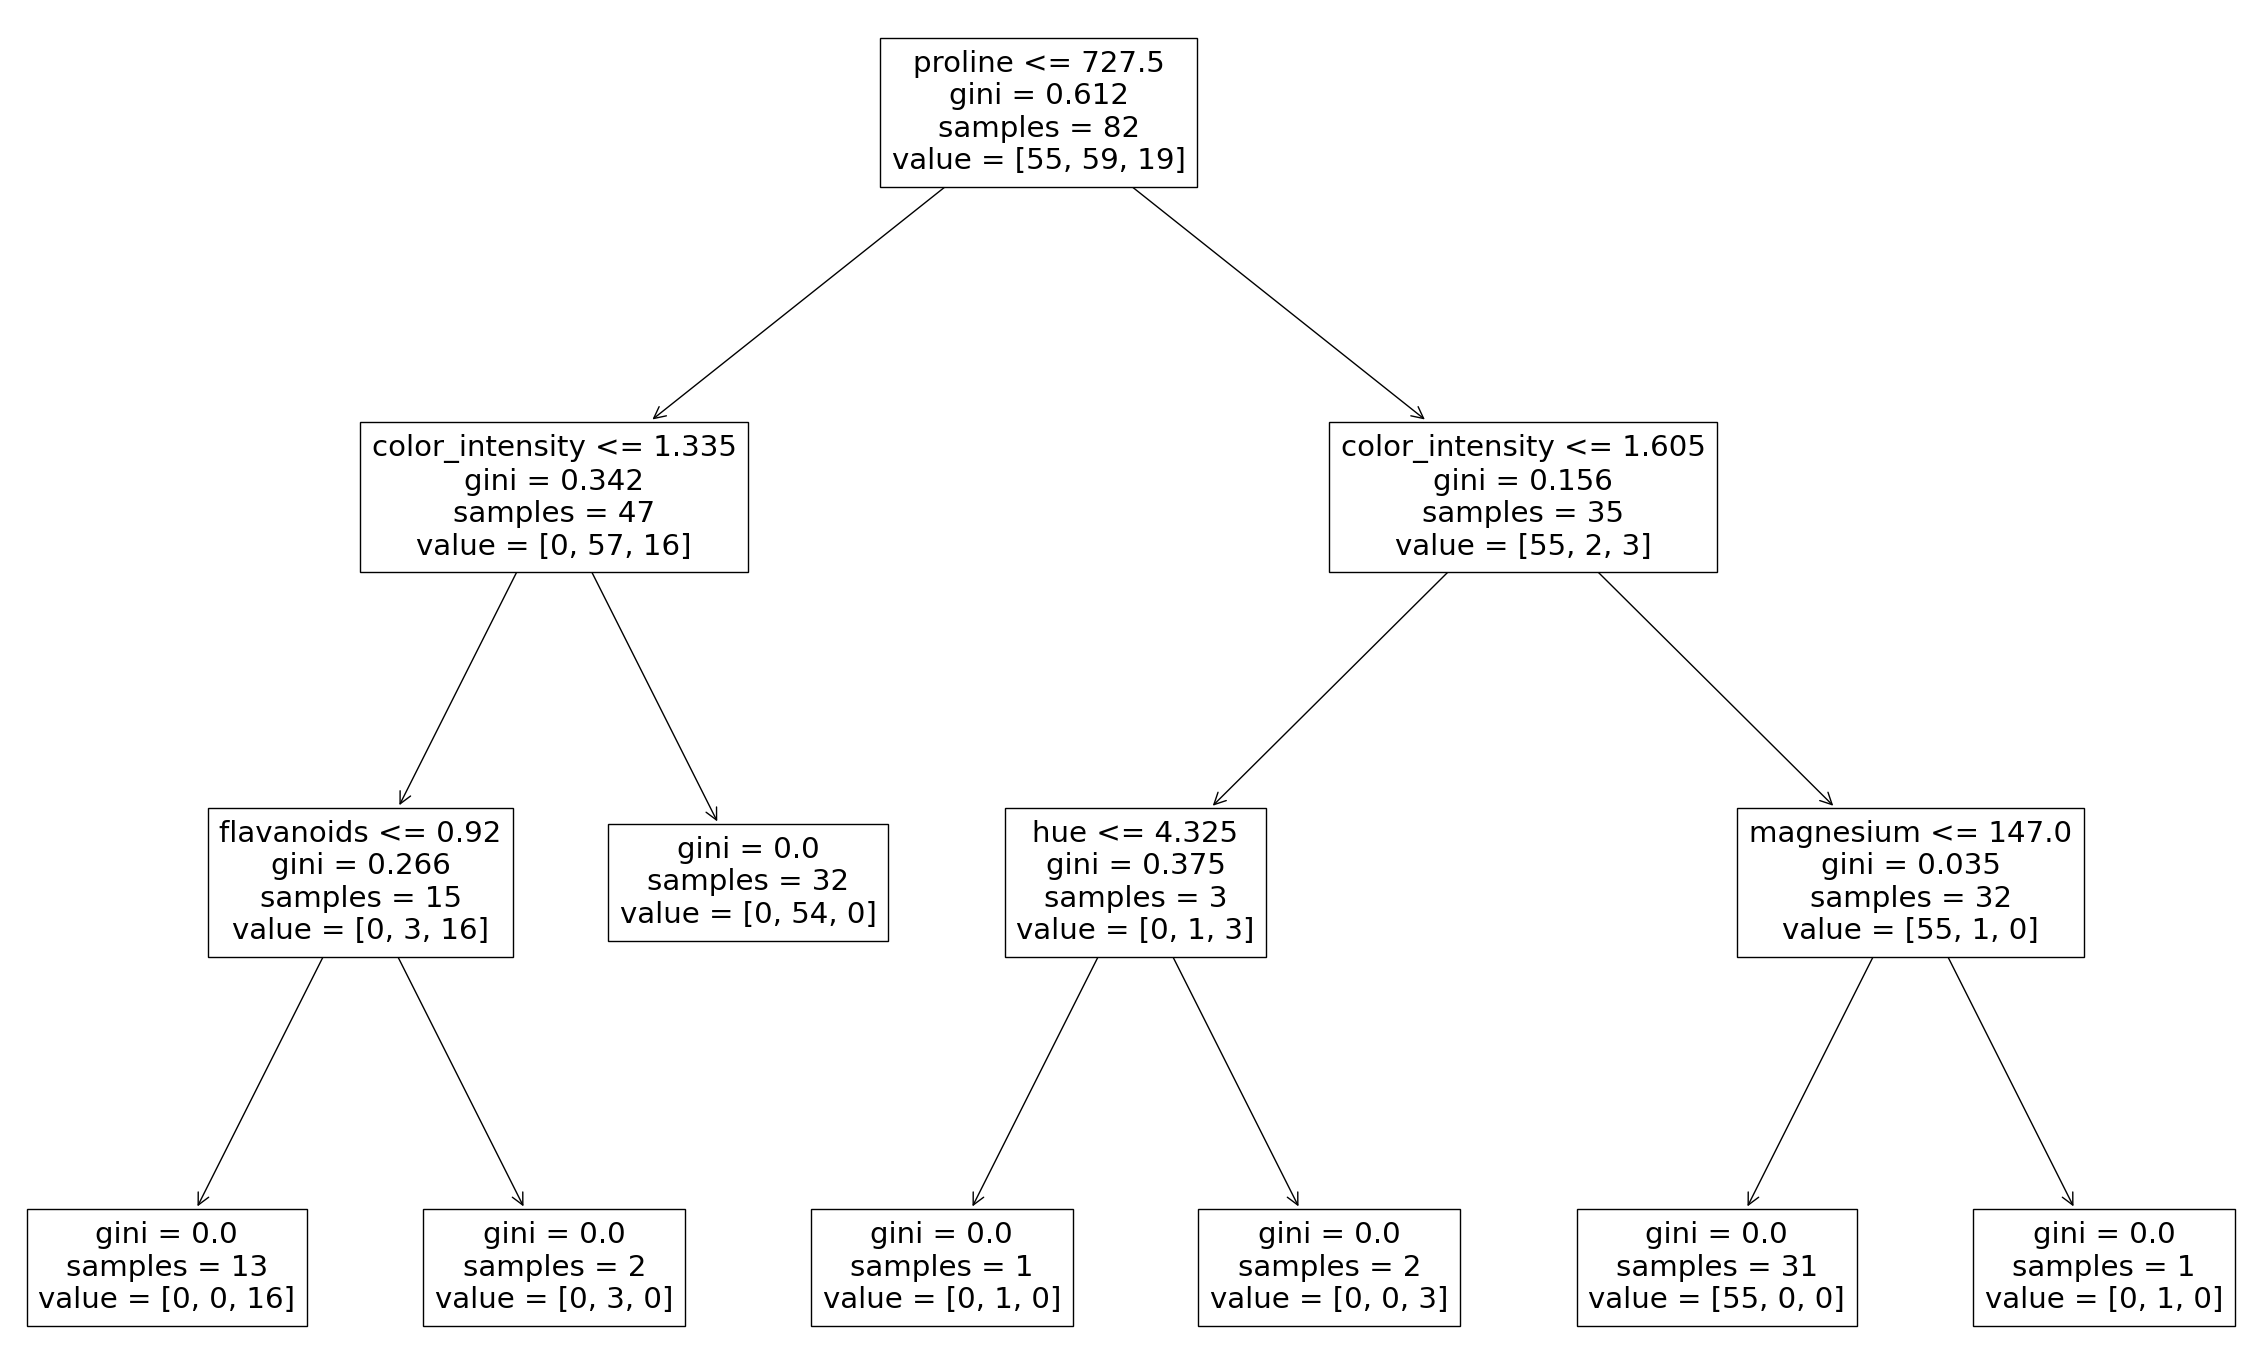
Bu yerda biz yakuniy bashorat bo‘yicha ovoz berish uchun ishlatilgan birinchi qaror daraxtini ko‘rishimiz mumkin. Shunga qaramay, klassifikator indeksini o‘zgartirish orqali siz yig‘ilgan har bir daraxtni ko‘rishingiz mumkin.
W3Schools Pathfinder
Yutuqlaringizni kuzating – bu bepul!