

DS ma’lumotlarni tayyorlash
Ma’lumotlarni tahlil qilishdan oldin Data Scientist ularni ajratib olishi, tozalashi va qimmatli holga keltirishi kerak.
Pandas yordamida ma’lumotlarni ajratib olish va o‘qish
Ma’lumotlarni tahlil qilishdan oldin ularni import qilish/ajratib olish kerak.
Quyidagi misolda Pythonda Pandas yordamida ma’lumotlarni qanday import qilishni ko‘rsatamiz.
Salomatlik ma’lumotlari joylashgan CSV faylni import qilish uchun read_csv() funksiyasidan foydalanamiz:
Misol
import pandas as pd
health_data = pd.read_csv("data.csv", header=0, sep=",")
print(health_data)
O‘zingiz sinab ko‘ring »
Misol izohi
- Pandas kutubxonasini import qiling
- Data frame’ga
health_datadeb nom bering. header=0o‘zgaruvchilar nomlari yozilgan sarlavhalar birinchi qatorda joylashganini bildiradi (Pythonda 0 birinchi qatorni anglatishini unutmang)sep=","qiymatlar orasida ajratuvchi sifatida "," ishlatilishini bildiradi. Buning sababi — biz .csv (comma separated values — vergul bilan ajratilgan qiymatlar) turidagi fayldan foydalanmoqdamiz
Maslahat: Agar CSV faylingiz katta bo‘lsa, faqat dastlabki 5 ta qatorni ko‘rsatish uchun
head() funksiyasidan foydalanishingiz mumkin:
Misol
import pandas as pd
health_data = pd.read_csv("data.csv", header=0, sep=",")
print(health_data.head())
O‘zingiz sinab ko‘ring »
Ma’lumotlarni tozalash
Import qilingan ma’lumotlarga qarang. Ko‘rib turganingizdek, ma’lumotlar noto‘g‘ri yoki qayd etilmagan qiymatlar tufayli "iflos":
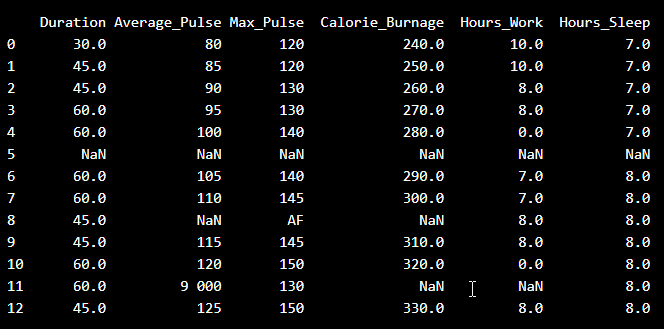
- Ba’zi maydonlar bo‘sh
- O‘rtacha puls 9 000 bo‘lishi mumkin emas
- 9 000 bo‘shliq ajratuvchisi sababli sonli bo‘lmagan qiymat sifatida qabul qilinadi
- Maksimal puls bo‘yicha kuzatuvlardan biri "AF" deb belgilangan, bu esa hech qanday ma’noga ega emas
Demak, tahlil o‘tkazish uchun ma’lumotlarni tozalashimiz kerak.
Bo‘sh qatorlarni olib tashlash
Sonli bo‘lmagan qiymatlar (9 000 va AF) yetishmayotgan qiymatlar bilan bir xil qatorlarda ekanini ko‘ramiz.
Yechim: bu muammoni hal qilish uchun kuzatuvlari yetishmayotgan qatorlarni olib tashlashimiz mumkin.
Pandas yordamida ma’lumotlar to‘plamini yuklaganimizda barcha bo‘sh kataklar avtomatik ravishda "NaN" qiymatlariga aylantiriladi.
Shunday qilib, NaN kataklarni olib tashlash bizga tahlil qilish mumkin bo‘lgan toza ma’lumotlar to‘plamini beradi.
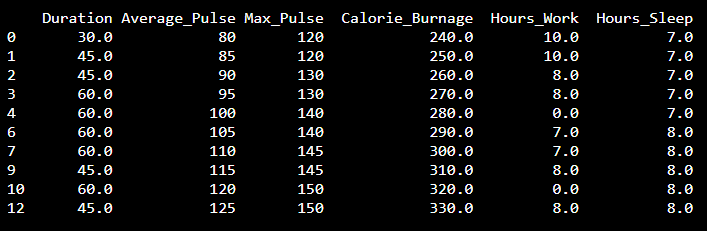
NaN qiymatlarni olib tashlash uchun dropna() funksiyasidan foydalanishimiz mumkin. axis=0 NaN qiymatga ega barcha qatorlarni olib tashlamoqchi ekanimizni bildiradi:
Natijada NaN qatorlari bo‘lmagan ma’lumotlar to‘plami hosil bo‘ladi:
Ma’lumotlar kategoriyalari
Ma’lumotlarni tahlil qilish uchun qanday turdagi ma’lumotlar bilan ishlayotganimizni ham bilishimiz kerak.
Ma’lumotlarni ikkita asosiy kategoriyaga ajratish mumkin:
- Miqdoriy ma’lumotlar - son bilan ifodalanishi yoki miqdoriy baholanishi mumkin. Ikkita kichik kategoriyaga bo‘linadi:
- Diskret ma’lumotlar: sonlar "butun" holda sanaladi, masalan, sinfdagi o‘quvchilar soni, futbol o‘yinidagi gollar soni
- Uzluksiz ma’lumotlar: sonlar cheksiz aniqlikka ega bo‘lishi mumkin, masalan, insonning vazni, poyabzal o‘lchami, harorat
- Sifatiy ma’lumotlar - son bilan ifodalanmaydi va miqdoriy baholanmaydi. Ikkita kichik kategoriyaga bo‘linadi:
- Nominal ma’lumotlar: misol: jins, soch rangi, etnik kelib chiqish
- Tartibli (ordinal) ma’lumotlar: misol: maktab baholari (A, B, C), iqtisodiy holat (past, o‘rta, yuqori)
Ma’lumotlaringiz turini bilsangiz, ularni tahlil qilishda qaysi usuldan foydalanish kerakligini bilib olasiz.
Ma’lumot tiplari
Ma’lumotlar to‘plamimizdagi ma’lumot tiplarini sanab chiqish uchun info() funksiyasidan foydalanishimiz mumkin:
Natija:
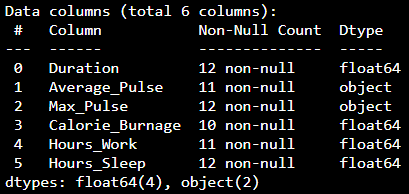
Ko‘rib turganingizdek, ushbu ma’lumotlar to‘plamida ikki xil ma’lumot tipi mavjud:
- Float64
- Object
Bu yerda object tipidagi qiymatlardan hisoblash va tahlil qilish uchun foydalana olmaymiz. object tipini float64 ga o‘tkazishimiz kerak (float64 — Pythonda o‘nli kasrli son).
Ma’lumotlarni float64 ga o‘tkazish uchun astype() funksiyasidan foydalanishimiz mumkin.
Quyidagi misol "Average_Pulse" va "Max_Pulse" ni float64 ma’lumot tipiga o‘tkazadi (qolgan o‘zgaruvchilar allaqachon float64 ma’lumot tipida):
Misol
health_data["Average_Pulse"] = health_data['Average_Pulse'].astype(float)
health_data["Max_Pulse"] = health_data["Max_Pulse"].astype(float)
print (health_data.info())
O‘zingiz sinab ko‘ring »
Natija:
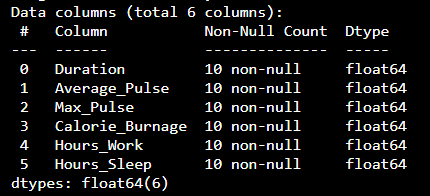
Endi ma’lumotlar to‘plamida faqat float64 ma’lumot tiplari bor.
Ma’lumotlarni tahlil qilish
Ma’lumotlar to‘plamini tozalab bo‘lgach, ma’lumotlarni tahlil qilishni boshlashimiz mumkin.
Ma’lumotlarni umumlashtirish uchun Pythonda describe() funksiyasidan foydalanishimiz mumkin:
Natija:
| Duration | Average_Pulse | Max_Pulse | Calorie_Burnage | Hours_Work | Hours_Sleep | |
|---|---|---|---|---|---|---|
| Count (soni) | 10.0 | 10.0 | 10.0 | 10.0 | 10.0 | 10.0 |
| Mean | 51.0 | 102.5 | 137.0 | 285.0 | 6.6 | 7.5 |
| Std | 10.49 | 15.4 | 11.35 | 30.28 | 3.63 | 0.53 |
| Min | 30.0 | 80.0 | 120.0 | 240.0 | 0.0 | 7.0 |
| 25% | 45.0 | 91.25 | 130.0 | 262.5 | 7.0 | 7.0 |
| 50% | 52.5 | 102.5 | 140.0 | 285.0 | 8.0 | 7.5 |
| 75% | 60.0 | 113.75 | 145.0 | 307.5 | 8.0 | 8.0 |
| Max | 60.0 | 125.0 | 150.0 | 330.0 | 10.0 | 8.0 |
- Count - kuzatuvlar sonini hisoblaydi
- Mean - o‘rtacha qiymat
- Std - standart chetlanish (statistika bobida tushuntiriladi)
- Min - eng kichik qiymat
- 25%, 50% va 75% - persentillar (statistika bobida tushuntiriladi)
- Max - eng katta qiymat
W3Schools Pathfinder
Yutuqlaringizni kuzating – bu bepul!